Was ist Atlassian Rovo? (und was bringt es Teams wirklich?)
Rovo ist Atlassians KI-Lösung, die euch hilft, Antworten aus eurem Unternehmenswissen zu finden, Aufgaben zu automatisieren und bessere Entscheidungen auf Basis vernetzter Informationen zu treffen. Der Kern ist nicht „noch ein Chatbot“, sondern ein Set aus KI-Bausteinen, die in Atlassian Cloud (u. a. Jira, Confluence, Jira Service Management) auftauchen.
Der praktische Nutzen entsteht immer dann, wenn Wissen zwar vorhanden ist – aber verteilt: Tickets, Seiten, Dateien, Chats, Wikis, Drittsysteme. Rovo setzt genau hier an: finden → verstehen → handeln.
Die 4 Bausteine von Rovo – und wann du welchen nutzt
Rovo Search: wenn du „das Ding“ finden willst
Rovo Search ist eine KI-gestützte, zentrale Suche über verbundene Quellen. Im Unterschied zur klassischen Suche liefert sie nicht nur Linklisten, sondern kann Ergebnisse zusammenfassen und Folgefragen vorschlagen.
Wann sinnvoll?
- du brauchst schnell ein bestimmtes Ticket, eine Seite oder Datei
- du willst filtern (Typ, Aktualität etc.)
Rovo Chat: wenn du eine Antwort, Analyse oder Aktion willst
Rovo Chat funktioniert wie ein Teamkollege: du fragst in natürlicher Sprache, bekommst kontextbezogene Antworten – und kannst teils direkt Aktionen anstoßen (z. B. Confluence-Seite anlegen, Jira-Vorgang zuweisen).
Wann sinnvoll?
- du willst zusammenfassen, brainstormen, Muster erkennen
- du willst in einem Schritt zur nächsten Handlung kommen
Rovo Agents: wenn wiederkehrende Arbeit „delegierbar“ ist
Agents sind KI-Helfer, die auf Basis eurer Vorgaben und erlaubter Daten Aufgaben erledigen können – wichtig: innerhalb eurer Berechtigungen.
Typische Agent-Jobs:
- strukturierte Zusammenfassungen (Incidents, Projekte, Releases)
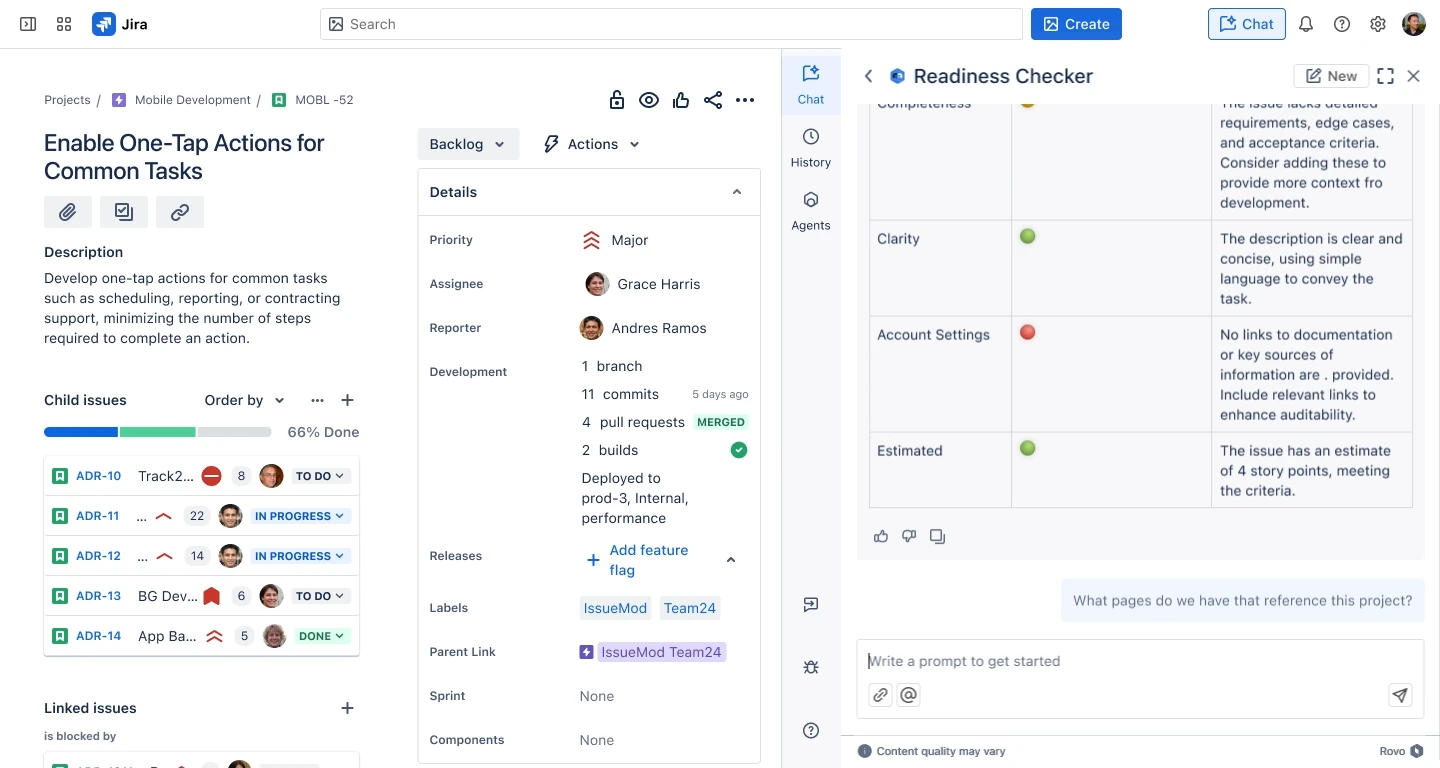
- Qualitätschecks (z. B. „Work Readiness“) oder Workflow-Aufgaben in Jira
Rovo Studio: wenn du eigene Agents/Workflows bauen willst
Rovo Studio ist der Teil, mit dem ihr eigene KI-Agents und Workflows erstellen könnt – ohne zwingend programmieren zu müssen (No-/Low-Code).
Merksatz (Search vs Chat vs Agent):
- Search = auffinden
- Chat = verstehen + nächste Schritte ableiten
- Agent = wiederkehrende Arbeit ausführen (mit Guardrails)
So arbeitet Rovo mit euren Daten: Konnektoren, Index, Berechtigungen
Konnektoren: nicht alles ist automatisch „drin“
Rovo kann Daten aus Atlassian-Tools und Drittquellen nutzen – aber admin-managed Konnektoren werden nicht automatisch aktiv, sondern müssen bewusst verbunden werden. Zusätzlich gibt es Smart-Link-basierte Verbindungen, die weniger Setup erfordern.
Wichtig für Admins: Wenn ihr Drittquellen verbindet, wird – je nach Connector – der Workspace indexiert (z. B. Drive/SharePoint), und ihr könnt den Scope über Mechanismen wie Blocklists eingrenzen.
Berechtigungen: Rovo „sieht“ nicht mehr als der User
Atlassian beschreibt explizit, dass Rovo bestehende Berechtigungen respektiert: Zwei Nutzer können unterschiedliche Ergebnisse bekommen, abhängig davon, worauf sie Zugriff haben.
Das ist zentral, weil es den Unterschied macht zwischen „KI als Risiko“ und „KI als kontrollierbares Werkzeug“.
Datenschutz & Governance: die wichtigsten Punkte für DACH-Organisationen
Hier die Punkte, die ich in Projekten immer zuerst kläre – weil sie später teuer werden:
Was wird gespeichert?
- Für Rovo werden Inhalte aus verbundenen Drittapps indexiert und zusammen mit Berechtigungsinfos gespeichert, damit nur erlaubte Inhalte angezeigt werden.
- Für Chat/Agents werden Ein- und Ausgaben laut Atlassian 30 Tage für Safety/Security aufbewahrt.
Welche Modelle/LLMs sind im Spiel?
Atlassian nennt eine Mischung aus Atlassian-gehosteten und Drittanbieter-LLMs; wichtig ist: Die externen Anbieter sollen Inputs/Outputs nicht speichern oder zum Training verwenden (laut Atlassian Doku).
Data Residency & Compliance
Atlassian sagt, dass Data Residency für Rovo unterstützt wird, wenn sie aktiviert/pinned ist. Zudem verweist Atlassian auf SOC 2/ISO 27001 für Rovo/AI sowie den Hinweis, dass Rovo aktuell nicht HIPAA-konform ist.
Governance für Agents (Praxisregel)
- Wer darf Agents erstellen? Wer reviewed/veröffentlicht?
- Welche Quellen sind „erlaubt“? Welche sind tabu?
- Welche Aktionen dürfen Agents ausführen – und nur nach Bestätigung?
Wenn ihr das nicht festlegt, bekommt ihr sehr schnell „Shadow Agents“ und uneinheitliche Qualität.
Praxis: 9 Use Cases, die sich in Jira, Confluence & JSM bewährt haben
In Jira (Delivery/Projektarbeit)
- Work-Readiness prüfen (fehlende Akzeptanzkriterien, unklare Tickets)
- Stakeholder-Update aus Tickets (Blocker, Risiken, nächste Schritte)
- Release-Notizen/Change-Summary vorbereiten (mit Quellenlinks)
In Confluence (Wissensarbeit)
- „Finde die Antwort“: Richtlinie/Prozess/Entscheidung inkl. Quellenlinks
- Meeting-Notizen zusammenfassen + Action Items ableiten
- Onboarding-Guide personalisieren („Was muss ich in Woche 1 wissen?“)
In Jira Service Management (ITSM/ESM)
- Incident-Zusammenfassung: Timeline, Impact, offene Tasks (aus Ticket + KB)
- „RCA-Light“: Hypothesen & nächste Diagnoseschritte (als Vorschlag, nicht als Wahrheit)
- Knowledge-Artikel-Vorschläge zu Tickets (Deflection-Ansatz)
Quickstart: Rovo in 30 Tagen einführen (ohne Chaos) – von Atlassian
Woche 1: Fokus setzen
- 2–3 Use Cases auswählen (Impact > Spielerei)
- Datenquellen priorisieren (Confluence/Jira zuerst, dann Drittquellen)
Woche 2: Sauber verbinden
- Konnektoren bewusst aktivieren, Scope begrenzen (Blocklist)
- Berechtigungen „härten“ (Least Privilege)
Woche 3: Pilot + Agent-Briefs
- Pilotgruppe (10–30)
- 1–2 Agents mit dem Agent-Brief-Template definieren (siehe oben)
- Feedbackkanal + „Was war hilfreich/was fehlte?“
Woche 4: Messen & skalieren
- Nutzungstrends anschauen (Chat/Agents) und wiederkehrende Fragen sammeln
- „Top 10 Prompt Patterns“ als Team-Standard dokumentieren
- Rollout erweitern – erst danach mehr Datenquellen